跳至主要內容

閱讀者與創作者的故事-第十三個故事

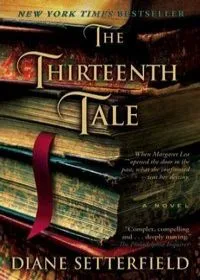
第十三個故事英文書封

這其實是一個悲傷的故事。當我看到是作者與愛書人的故事時,想到了《查令十字路84號》這本經典的愛書人與舊書店的書信集,在我報名參與這個活動時,正在讀《查令十字路84號》。

在讀完後卻是完全不一樣的感覺,因為書中提及的小說,倒讓我覺得羅曼史的色彩多了些,部份的情節讓我想起Agota Kristof的《惡童日記》,但總是比《惡童日記》緩和一點,帶點童話故事的色彩。附帶一提《惡童日記》和薩德的《索多瑪120天》這兩本的成人色彩較濃厚,但《惡童日記》又多了戰爭的無奈與悲哀。

愈扯愈遠。

這個故事在前幾頁開始時,有很多是作者對於書店與書的個人看法:

「…書店是事情的本質,是書籍的寶庫,是所有書籍的庇護處,包括作者曾經深情書寫,但現在卻無人想要的書。…書店是閱讀的地方。」
當然,那封釣足書中主角瑪格莉特胃口的信,也是在顯示一個成名作者的無奈與對記者的嘲諷。

在開始閱讀時,速度是非常緩慢的。這本書架構之奇特,前三分之一在說書、文字與作者的關連,還有近似於幻痛症的主人翁藉由閱讀傳說找尋已故作家身影的投射自己雙胞胎妹妹的行為連結,讓我可以慢慢閱讀。但中間開始,當瑪格莉特到達溫特女士的宅邸,當溫特女士開始敘述伊莎貝爾的故事時,一個家族悲劇就開始呈現在眼前,就像瑪格莉特以往閱讀的古典或十九世紀的羅曼史小說,有落沒貴族、家教老師,還有很多「Happily ever after」的故事,但不同於那些故事的是,溫特女士自己的故事只是一個次要的情節。

在這一部份裡,我們看到的是驚悚、還有急於找出「真相」的過程。不論書中的瑪格莉特或是拿著書本閱讀的我,都無法在這個部份煞車,她請人找尋故事中的人物存在的真實性及部份人物的下落,再配合她自己探訪的過程已經拼湊出故事的結局,剩下的只是找出「真相」,而這個「真相」其實就是「過程」。就像電影或連續劇,我們往往急於知道結局是什麼,實際上我們也都能預料結局為何,但真正有趣的就是導致這個結局的過程和過程之中我們不能預料的變數,這個變數往往會讓結局出乎意料之外。

除了溫特女士的故事外,也隱藏了瑪格莉特自己的故事,雖然在一開始就簡單的帶過她自己的故事,但瑪格莉特的故事卻成了整個故事中次要的故事,卻也成了這個故事的變因之一,如果她不是那麼思念自己的雙胞胎姐妹或是完全不知道這回事,也許她不會寫那篇研究某對雙胞胎作家的文章,也不會吸引溫特女士的注意,就不會有整個故事。

結局應該在最適合的地方結尾,比方說,那只箱子、第十三個故事、瑪格莉特的釋懷…當我讀到試讀本第439頁時,我覺得故事也該結束了,雖然次要的配角會影響到故事的發展,但也不需要全部放上場,有種斷尾斷不乾淨拖在後面的感覺,而作者好心的安排,讓故事中的所有次要人物都有了「Happily ever after」的結局。也許是要表現出瑪格莉特心態上的轉變,由陰鬱轉而開朗,像是她最愛的《Jane Eyre》有一個美好的結局一樣,我卻對於後面多出了的這幾段感到多餘,雖然在這一個章節,作者把它取名為「開場」,也終於知道那位讓瑪格莉特以密碼方式記住的名字是什麼,以及,她請溫特女士帶了什麼話。但我非常喜歡整個故事開始時,作者對於文字和書的看法,比如說:

人在閱讀陌生作家的作品時,自然會期盼獲得特殊的感受。
這兩句話,的確道盡了自己在讀書時的期待。

據說作者在寫接下來的故事,據說已經開始改編為電影劇本。如果這本小說的最後幾段放在新小說的開始,我想是蠻適合的,也不會讓人感到多餘,也許這也是作者為什麼把最後的章節取名為「開場」以預告另一個故事的開始。


自從在誠品買了一個布製書套後,覺得那真的是非常實用的東西,拿來包圖書館的書也很恰當(對公用書有種潔癖感),這次博客來送的書套質感也不錯,真是讓我蠢蠢欲動。

隨選歷史閱讀:
Powered by Stuff-a-Blog
Tags:

留言

  1. 前幾天訂書時才順便收到這本書的「試讀本」,想不到在這就看到容顏的心得了呢。

    回覆刪除
  2. Hello~
    因為剛好從twitter上看到有試讀徵文活動,所以就報名啦!也很高興收到試讀的書,我應該沒有透露太多劇情:p
    試讀本還是有差,漏掉一些標點符號和別字,而且封面白白的,但已經有書的感覺了,中文版的書封也不錯,不過我比較喜歡英文版的書封。

    回覆刪除

發佈留言

請勿匿名留言,待審核後才會出現。

此網誌的熱門文章

停不下來的更新

一直更新Blog的版型,我必須承認是一件很無聊的事,不過這次除了版型的更動外,連分類和文章內文也做了變動。 先說分類吧!在Blogger叫做Label,不過,Blogger在分類上有一些bugs,只能使用英文,以前這裡的分類大多都是中文分類,結果在link上就是一堆亂七八糟的亂碼,所以我把它改成英文,同時細分一些項目,把出版的文章和一些教學的文章分開來,雖然已經很久沒寫新的,不過既然放上來就做個分類。然而就在新舊label移轉之後,發現中文的label還會存在,而且還會出現莫名奇妙的幽靈數字,Blogger知道這是個bug,不過似乎一直沒有修復的跡象。所以在分類上就出現了如右圖一般的情況,在英文標籤裡會有文章,但是在中文標籤裡是沒有文章出現的,但奇怪的是,有些中文標籤已經不見了,然而在Beauty-Beta這個部落格裡,我也做了分類上的變動,由於以前用英文開頭的Label,所以在label的變動上倒是不用擔心會有這樣的情況。 再來是文章的內容,把以前的文章重新分類,標題前面的一些全形符號或是分類刪掉,除了一些比較特殊的,我會留著,例如壹陸壹,因為在label裡為了統一,我留著原本的E61,但人家的店名是壹陸壹,所以留下文章標題前面的中文分類,另外像是Entertainment項目裡,可能有音樂,可能有電影,就會在前面留下中文分類。 前簡單的CSS和HTML改成現在的XML,這無疑是讓我們再多學些東西,能有時間鑽研當然是好事,可是轉換後,我一直沒有時間去改,當然多半也是因為懶,到現在也是拿別人做好的版型去改配色而已,所以像裡面的設定、安裝的widget和analytics的javascript都要一個一個重新裝,上個星期幾乎每天都弄到天亮才睡,只為了整理這個blog。也因為之前在blog裡放了technorati的分類,所以還要修改以前的文章,把它們加入technorati,還有裡面的語法要更改,所以這個星期甚至下個星期都會一直收到這裡的更新訊息,對於不斷收到訊息干擾的朋友們,在這裡說聲抱歉。 在版面上因為blogger系統在feed接受上的更新,所以還有四個東西沒加進去,分別是最近的文章(Recent Post)、Comments(目前是用別人寫的widget)還有GVO的feed訂閱顯示、Beauty-Beta的訂閱顯示也都還沒放上去。 在Feed訂閱上,以前bl...

用Claude Code做一個AI飲食營養分析Bot:從拍照辨識到條碼查詢的實作筆記

沒想到在十多年後,因為想做飲食營養控管,所以自己利用 AI 開始做一個簡單的食品營養分析工具,能分析我每餐的飲食是否充足或過量,並提供有依據的飲食建議。 最初的雛形是基於以往曾參與「 Food Open Data 」倡議的經驗,我希望用最簡單的方式,拍照-->AI辨識與分析-->提供建議,然後統計一段期間的營養攝取狀況。 最初的想法 當我把我的雛形想法告訴 AI 後,Claude Code 很快的就幫我設計好雛形、教我如何申請Telegram Bot,這些步驟都寫得很清楚,整個雛形做好不用半天,我還愣住了,怎麼可能這麼簡單?難怪那些應用程式公司只把飲食營養分析當作一個「附加功能」,主要目的是蒐集其他的生理監測資料,但這些公司蒐集資料的用途,我自己在處理過美國資料經紀公司所販售的資料隱私資訊後,這是值得關心的議題,但不在此篇文章裡討論。 不過,我只專注在飲食分析項目,我覺得這個功能如果可以做好,再想想其他的。最初的想法很宏大,因為家人與自己患有慢性疾病,所以特別針對某些族群設計,但事實上,如果沒有實際的使用情境,可能也無法做出符合需求的產品。 於是我把這個Bot的使用者只鎖定在我自己的飲食分析上,那就簡單多了。 工具與環境限制 我在今年已經改用 Claude Cowork 與 Claude Code 協作,雖然 Claude Code 有一般介面版,但我大多數時間都開著終端機視窗使用 Claude Code,這樣比較能專心工作。 基於使用工具的習慣,我使用 Claude Code 開始建置,當時的模型雖然已經有Opus 4.8,但Sonnet 4.6已綽綽有餘,而後來出現的Fable 5 則用在其他專案裡。 因為只做給自己用,所以選擇最簡單的 Chatbot 形式;也因為我希望可以自由的使用而不是提供過多的個人資料給其他平台,選用 Telegram Bot,而不是台灣人常用的 LINE Bot ,而且 LINE上太多廣告,根本不想開它。 在衡量經濟現實及自我管理資料的想法後,目前這個 Bot 與資料庫只放在我的電腦裡,沒有上雲端,當電腦休眠、網路斷線時,Bot就會停止工作。 雖然只是給我自己使用,但我還是要求資料庫是加密儲存的,匯出資料時也必須加密。 台灣的飲食文化很多元 我不是開發者、也不是營養師,我自己也沒使用過其他的應用程式,所以無從理解在開發飲食營...

AI 提高產出,但誰得到好處?

我收集了 2026 年 3 月至 9 月由 Anthropic 研究團隊公開發表的 5 篇文章,讓 Claude 重新翻譯並編輯,並修改為習慣的閱讀語氣,以利閱讀。 Anthropic 今年 3 月發表的報告顯示,美國整體失業率沒有上升,但 22 到 25 歲的年輕人每月順利進入 AI 高曝露職業的比例比 2022 年低約 14%。這是我讀完今年他們發布的 5 份經濟研究摘要後,最常想起的一句話:「AI 讓產出變多」與「誰能把產出變成自己的收穫」,是兩個得分開回答的問題。 AI 做得到,不代表已經在做 過去大部分研究或媒體在衡量 AI 對工作的影響時,常問「AI 理論上能做哪些任務」。問題在於,AI 做得到,不代表企業或個人真的已經拿來用。 在這次閱讀的文章中,研究團隊提出「觀察曝露度」(Observed Exposure)。這個指標結合 O*NET(美國職業資訊網路,Occupational Information Network)的任務清單、理論可行性評分與 Claude 的實際使用資料,並對「自動化」與「工作用途」給予較高權重。 排名最高的是電腦程式設計師(約 75%)與資料輸入人員(約 67%),客服代表也名列前茅;另有 30% 的勞工觀察到曝露度為零。AI 目前的實際使用與理論能力還有一段距離。 在公布的研究中,高曝露職業的從業者有幾個共同特徵:女性比例高 16 個百分點、平均薪資高 47%、學歷較高、年齡也偏長。受衝擊的是中高薪的知識工作者,和「AI 先淘汰低薪年輕勞工」的直覺相反。 衝擊有多大?研究用差異中差異法比對,發現 ChatGPT 發布前後,高曝露職業的失業率未見系統性上升。唯一較清楚的訊號在 22 到 25 歲:這個年齡進入高曝露職業的新工作起始率,約比 2022 年低 14%。研究團隊也註明,這個結果僅勉強達到統計顯著。 同一套 AI,成果為何不同 在針對使用者研究的報告中,使用 6 個月以上 Claude 的人,其對話成功率為 73.1%,新使用者為 66.7%,相差 6.4 個百分點。控制任務類型後,差距縮到約 3 個百分點;再加上模型、使用情境、國家等變數,差距維持在約 4 個百分點。 Anthropic 曾假設,資深使用者會更傾向於把工作整包交給 AI 自動完成。研究的資料指向相反的方向:資深使用者更常與 Claude 來回...